Tim 排序
本页面将介绍 Tim 排序(Timsort),一种混合的、稳定的排序算法.
引入
Timsort 由 Python 核心开发者 Tim Peters 于 2002 年设计,并应用于 Python 语言,其巧妙结合了插入排序和归并排序的优点,针对数据集中的有序性进行了精确的优化,尤其适合处理包含大量部分有序子序列的数据集.CPython 从 2.3 版本开始使用 Timsort,之后从 3.11 版本开始将其归并顺序策略替换为 Powersort1.Timsort 也被广泛应用于其他编程环境,例如在 Java SE 7 中被用于对非原始对象数组进行排序.
本页介绍传统 Timsort,并以 CPython 3.6.5 中已修复栈不变量维护问题的归并规则为准2.
步骤
Timsort 的核心思想是通过识别和利用数据集中已有的有序性,提高排序效率,其主要包括以下步骤:
- 识别 Run:扫描待排序数组,识别出有序的连续子序列(Run);
- 扩展 Run:如果识别的 Run 长度小于
MIN_RUN,则使用插入排序对其进行扩展; - 归并 Run:Timsort 维护一个特殊的栈,采用特定的归并策略将栈中已有的 Run 合并成更大的有序序列.
识别 Run
首先,Timsort 会从左向右扫描数组,识别出连续的有序序列,这些有序序列被称为 Run:
- 升序 Run:如果后一个元素大于等于前一个元素,则继续扩展 Run.
- 降序 Run:如果后一个元素小于前一个元素,则继续扩展 Run,随后将该 Run 反转为升序.
扩展 Run
为了提高小规模数据的排序效率,Timsort 引入了一个 Run 最小的长度 MIN_RUN.其值一般根据待排序数组的长度动态计算,通常为 
- 如果识别的 Run 长度大于等于
MIN_RUN,则不需要额外操作,直接将 Run 压入栈中. - 如果识别的 Run 长度小于
MIN_RUN,则使用二分插入排序将该 Run 的后续元素插入到 Run 中,直到 Run 的长度达到MIN_RUN,然后将其压入栈中.
归并 Run
在 Timsort 中,归并排序是通过 栈 来管理和控制的.栈中保存了已经识别出的有序的 Run,并通过特定的归并规则控制栈中 Run 的合并,其目的是在合并时保持序列的平衡性和稳定性.
归并规则
Timsort 是一种稳定的排序算法,即相同元素在排序后仍然保持原有的相对顺序.为确保这一点,Timsort 在归并时只会合并相邻的、连续的 Run,而不会直接合并非相邻的 Run.因为非相邻的 Run 之间可能存在相同的元素,直接合并很有可能会打乱它们的相对顺序.
同时,为了控制合并的平衡性和待合并 Run 的数量,Timsort 要求栈中每组相邻的三个 Run 都满足以下不变量.记三个 Run 从栈顶向栈底的方向依次为 X、Y 和 Z:
- 条件一:
len(Z) > len(Y) + len(X) - 条件二:
len(Y) > len(X)
栈中只有两个 Run 时也要求 len(Y) > len(X).每次压入新 Run 后,mergeCollapse 会检查栈顶至多四个 Run,记它们从栈顶向下依次为 X、Y、Z、W,并按以下顺序决定是否合并2:
- 若
len(Z) <= len(Y) + len(X)或len(W) <= len(Z) + len(Y),则将 Y 与 X、Z 中较短的一个合并;X 与 Z 等长时选择 X; - 否则,若
len(Y) <= len(X),则合并 Y 与 X; - 否则,停止本轮合并,继续识别下一个 Run.
只检查所需 Run 均存在的条件;每次合并后重新确定 X、Y、Z、W 并重复上述过程.下图示意合并 X 与 Y 时栈的变化.
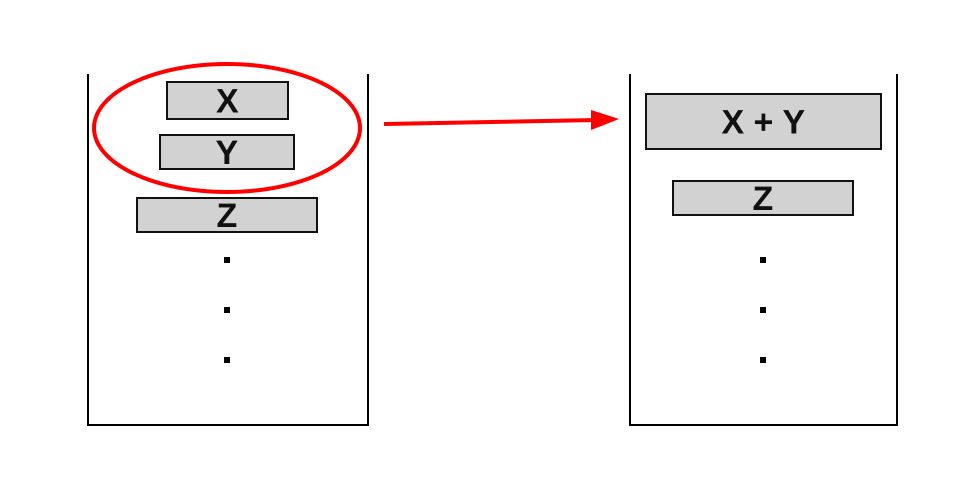
为什么需要检查第四个 Run?
仅检查栈顶三个 Run,可能在合并后遗漏栈中更深处的不变量失效.例如,依次压入长度为
这一缺陷会使根据全栈不变量推导的固定栈容量保证失效.CPython 在 2015 年修复了检查条件4.
归并优化
为了在归并不同长度的 Run 时提高效率并减少空间开销,Timsort 在归并前会通过二分查找精确定位需要处理的元素范围,只对需要移动的部分进行归并,具体方式为:
确定插入点:使用二分查找,找到第二个 Run 的第一个元素在第一个 Run 中的插入位置,以及第一个 Run 的最后一个元素在第二个 Run 中的插入位置.这样,可以缩小需要归并的范围,只对需要移动的元素进行处理;
临时缓冲区:传统的原地合并算法效率太低,需要大量的元素移动.为了减少这种开销,Timsort 使用一个临时缓冲区,将长度较小的 Run 复制到缓冲区中,然后逐步将元素从缓冲区复制回原数组.
例如,假设存在两个 Run A 和 B,分别为:
- Run A:
- Run B:
通过二分查找,可以确定:
- 元素
- 元素
因此,Run A 的前
加速模式
为进一步提升归并效率,Timsort 引入了 加速模式(Galloping Mode).在标准的归并过程中,算法会逐一比较两个 Run 中的元素,将较小的元素放入结果数组.然而,如果一侧的 Run 中有大量连续元素比另一侧的当前元素要小,逐一比较会造成不必要的开销.
为了解决这一问题,Timsort 设定了一个阈值 Min_Gallop(默认值为 Min_Gallop 时,算法会进入加速模式,快速定位元素位置,其具体步骤如下:
- 指数查找:从当前位置开始,算法以指数增长的步长
- 二分查找:一旦确定了包含目标元素的区间,算法会在该区间内使用二分查找,精确定位目标元素的位置.
通过这种方式,Timsort 可以跳过大量不必要的比较,快速处理一侧 Run 中连续的、较小(或较大)的元素,将它们批量移动到合并结果中.
然而,加速模式并非在所有情况下都更高效.在某些数据分布下,加速模式可能导致更多的比较次数.为此,Timsort 采用了动态调整策略:
- 阈值调整:维护一个可变的
Min_Gallop参数.当加速模式表现良好(即连续多次从同一 Run 中选取元素)时,Min_Gallop减Min_Gallop加
通过动态调整 Min_Gallop 的值,算法能够根据实际数据情况,在普通归并模式和加速模式之间取得平衡.对于部分有序或高度有序的数据,加速模式可以显著提高效率,使 Timsort 的性能接近
复杂度
Timsort 的时间复杂度取决于数据的有序性:
- 最优情况:
- 当数据已经有序或近似有序时,算法识别出的 Run 长度接近
- 当数据已经有序或近似有序时,算法识别出的 Run 长度接近
- 最坏情况:
- 若有
- 若有
识别 Run 花费 MIN_RUN 扩展短 Run 也共需
而对于空间复杂度,由于 Timsort 大致需要额外的
实现
伪代码实现
参考资料与注释
本页面最近更新:2026/9/28 01:09:54,更新历史
发现错误?想一起完善? 在 GitHub 上编辑此页!
本页面贡献者:Tiphereth-A, c-forrest, Great-designer, HeRaNO, shuzhouliu, yyyu-star
本页面的全部内容在 CC BY-SA 4.0 和 SATA 协议之条款下提供,附加条款亦可能应用